
ALSACE:通过教师语言选择与跨语言自蒸馏缓解多语言预训练语言模型的语言间性能差异
让同一个模型中的不同语言互相传授知识。 多语言预训练模型对同一问题在不同语言下经常给出不同回答。ALSACE 在不额外依赖有标注多语言数据的情况下,缓解这种知识与性能差异。
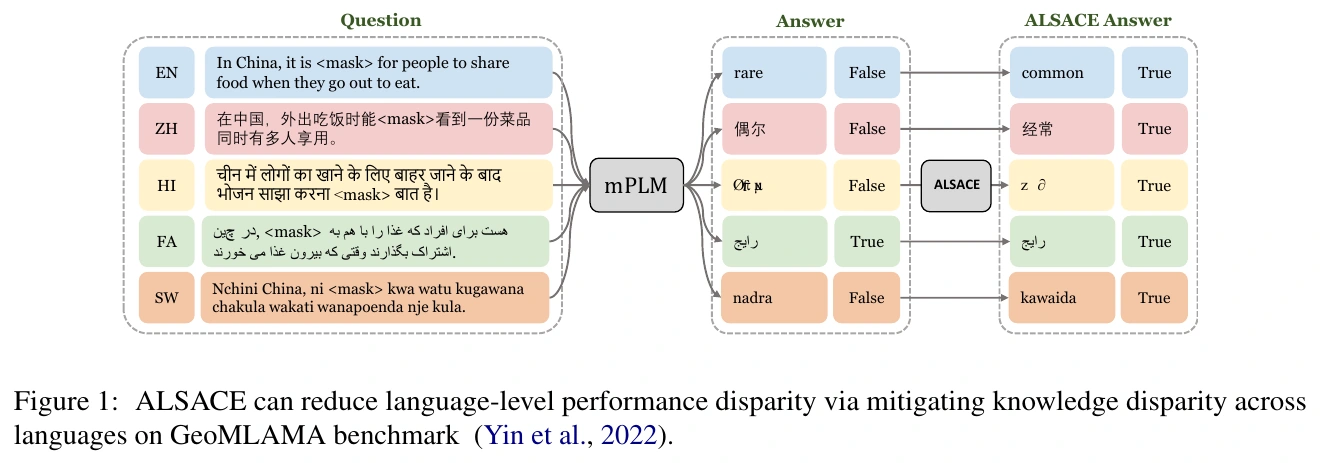
方法先通过跨语言多数投票生成伪标签,再根据各语言对伪标签的置信度选择可靠的教师语言。跨语言自蒸馏随后对齐教师语言与其他语言的预测分布。教师选择随任务而变化,高资源与低资源语言都可以提供有价值的知识。
论文使用 XLM-R 和 mT5,在 XNLI、PAWS-X、XCOPA 上评测,并通过 GeoMLAMA 探测文化相关知识。实验中,ALSACE 缩小了跨语言迁移差距,并提升多种语言的表现,有限资源设置下也观察到改善。方法通过无标注多语言输入共享模型中已有的知识。