
DiffCap:探索用于图像描述的连续扩散
通过对整句话去噪来生成图像描述。 DiffCap 探索用于图像描述的连续扩散:将描述词元表示为连续嵌入,训练时加入噪声,再以视觉特征为条件恢复句子。
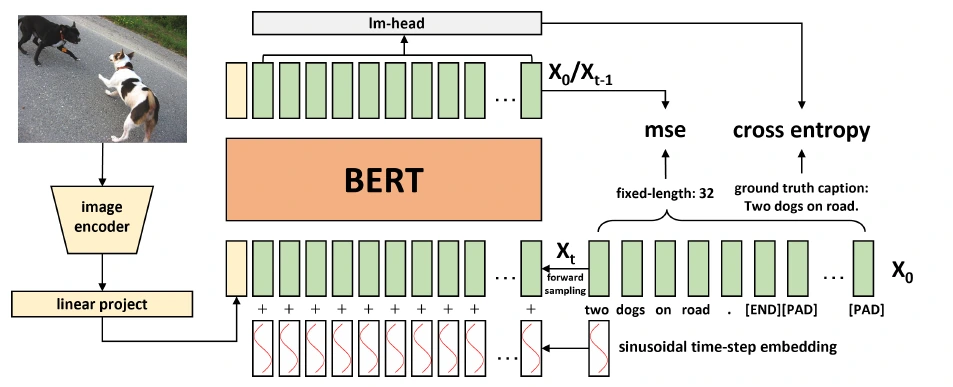
冻结的视觉编码器提供图像表示;投影后的图像特征与扩散时间步嵌入共同作为 BERT 式去噪器的条件,输出头将恢复的嵌入映射回离散词元。扩散作用于描述文本的嵌入,图像条件保持固定。
在 COCO Karpathy 测试集上,论文模型获得 31.6 BLEU-4 和 104.3 CIDEr,并使用 inter-distinct 与 self-BLEU 单独衡量描述多样性。实验体现了质量与多样性的取舍:描述质量与测试的非自回归基线相近,而评测中表现最好的自回归系统在标准质量指标上仍更高。