
HeadKV:融合检索与推理的注意力头级 KV 缓存压缩
ICLR 2025 (Poster) · PDF · 代码 · 评测数据 · BABILong 数据
把缓存分给真正需要它的注意力头。 HeadKV 将固定的逐层 KV 预算改为全模型共享预算,在各个注意力头之间分配。HeadKV-R2 用需要先推理、再检索的问题估计头的重要性,并根据各头对正确答案的注意力评分。预填充时,每个头保留基础预算,再获得与重要性成比例的额外预算;由末尾指令窗口的注意力选择保留哪些缓存条目。整个过程不修改模型权重。
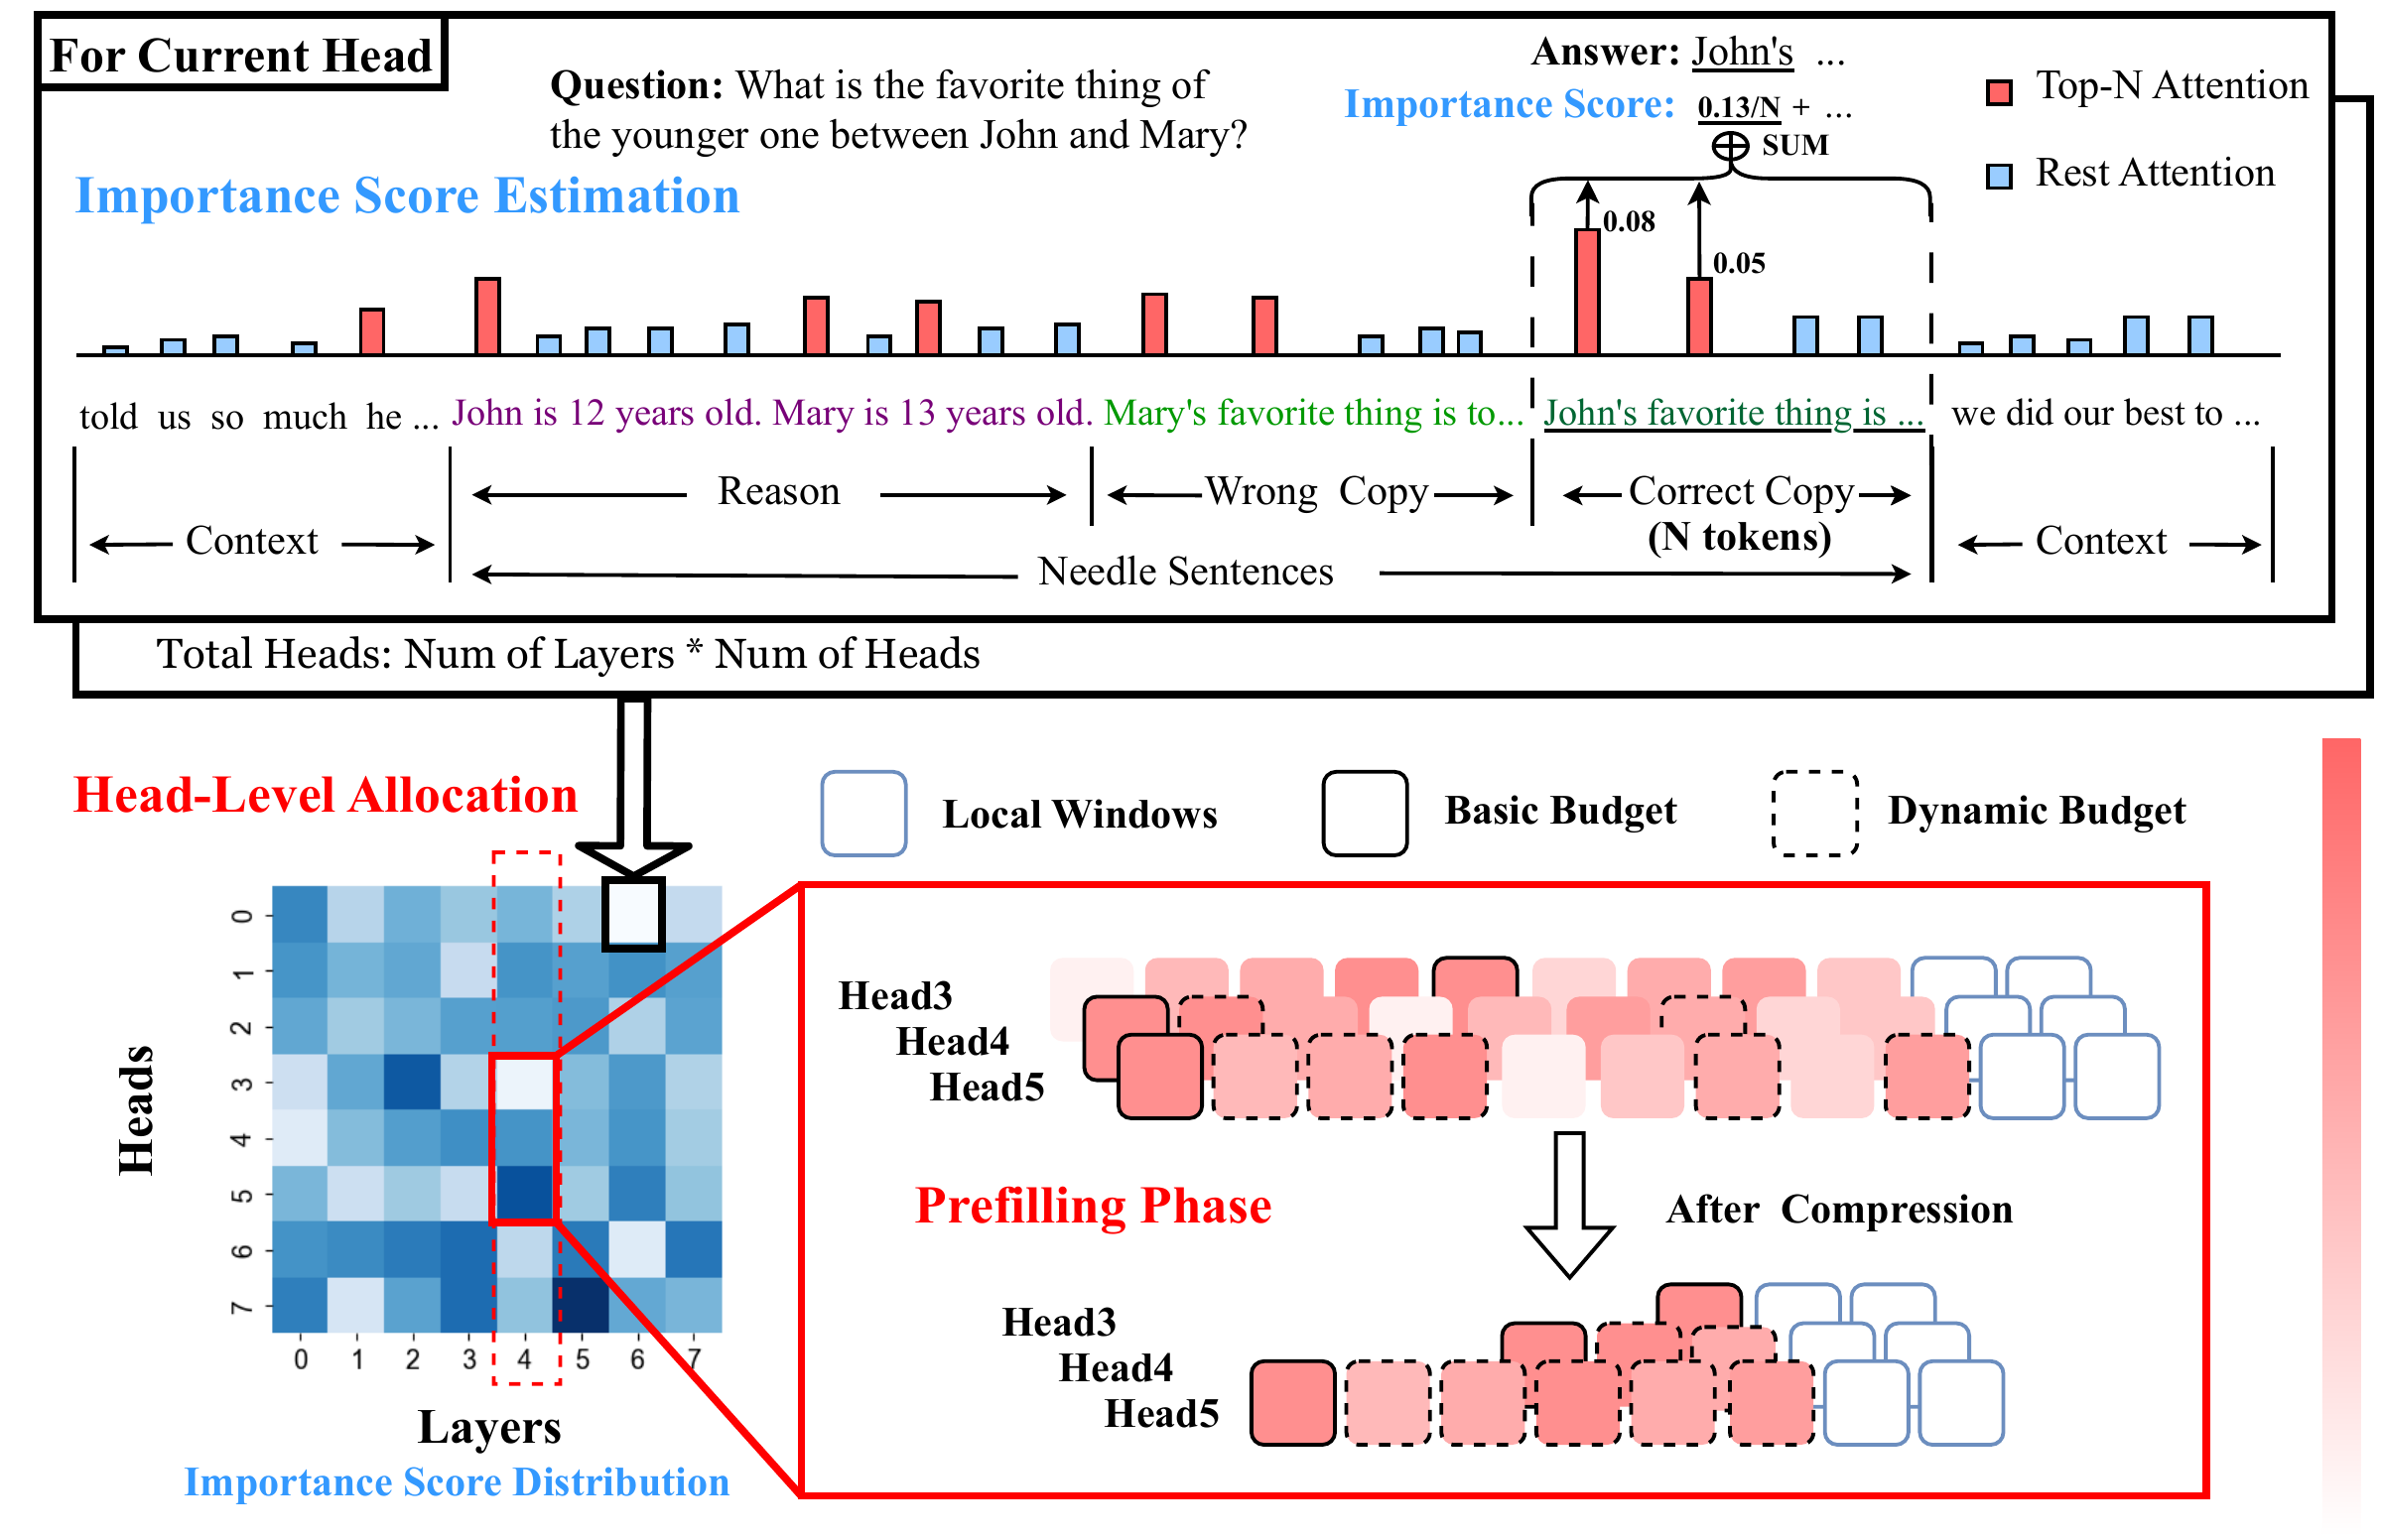
在 Llama-3-8B-Instruct 的六项 LongBench 问答任务上,平均 128 条缓存的得分为 32.00,完整缓存为 32.90:保留平均 8,683 token 输入约 1.5% 的缓存,维持约 97% 的性能。同预算 Ada-SnapKV 为 28.52。论文还评估了 Mistral-7B-Instruct、LooGLE、长文本检索及上下文推理,最明显的收益出现在缓存预算较小时。