
Last Layer Key-Value Cache is All You Need(只需最后一层的键值缓存)
COLM 2026 ER Workshop (Spotlight) · PDF
让所有层复用同一份历史。 标准 Transformer 为每层分别保存历史键值。LastKV 用已完成分块的最后一层 KV 构建共享历史,让后续所有层复用经过深层计算的上下文。这样既减少重复存储,也将过去的深层表示反馈到后续计算。
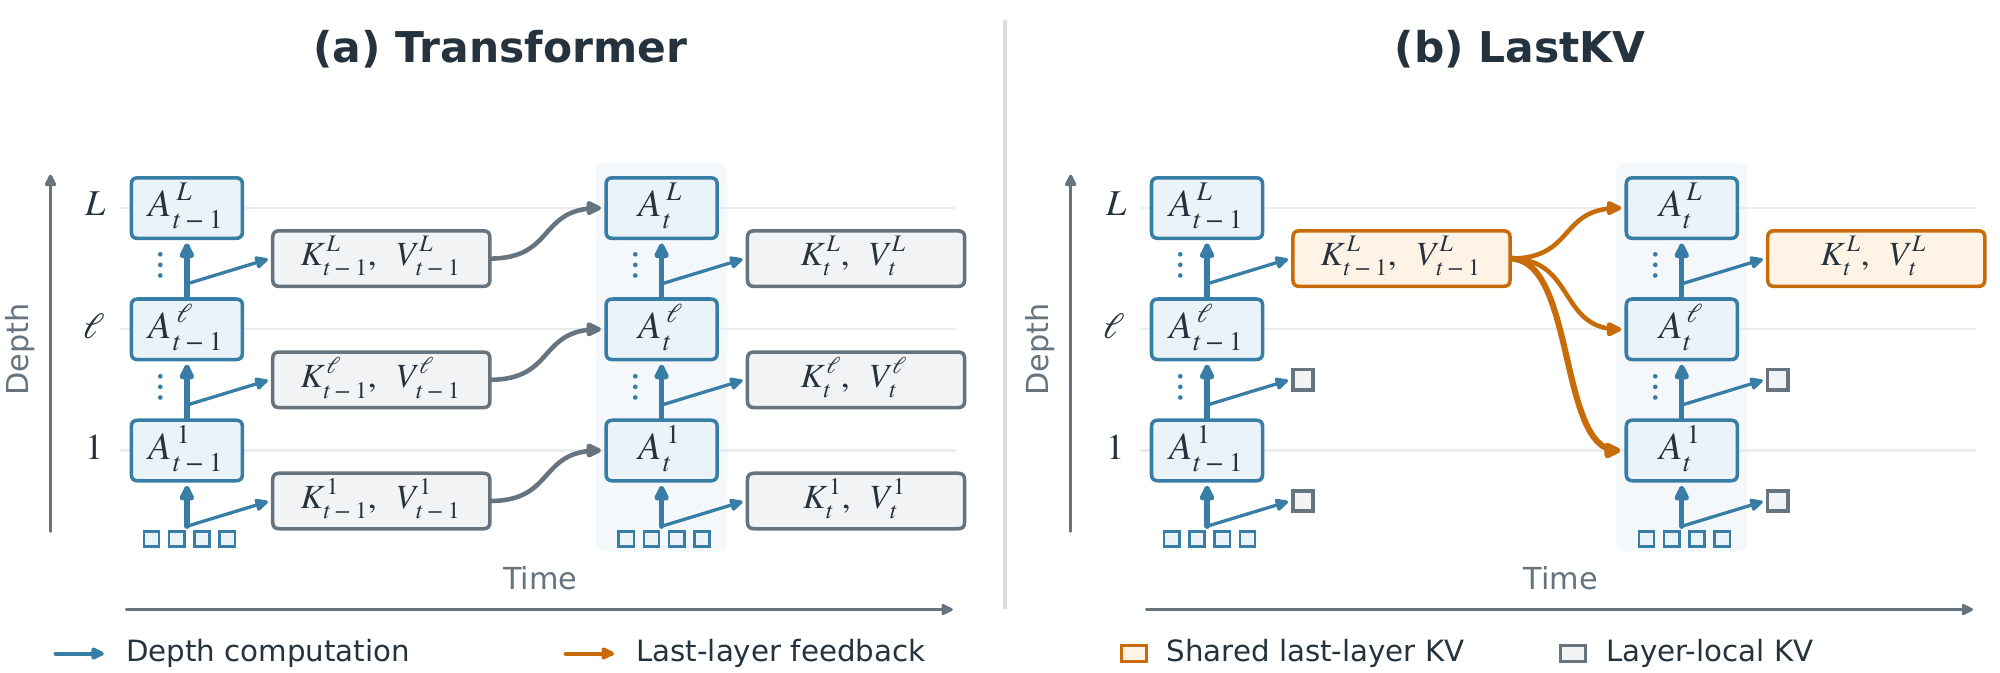
分块内部仍使用普通因果注意力并行处理 token。分块完成后,最后一层 KV 成为共享历史;通过可学习权重,将前一分块的逐层 KV 与最后一层 KV 混合,平滑分块边界。对于按整块处理的 T 个 token(T ≥ C)、L 层网络和大小为 C 的分块,保留的历史包含 T + (L−1)C 个 KV 位置,而标准 Transformer 需要 LT 个。序列越长,这一比例越接近标准历史缓存的 1/L;这一计数覆盖持久 KV 存储。
在相同长上下文预训练设置下,LastKV 在 124M 和 760M 上取得所比较方法中最高的平均 RULER 分数;124M 的平均分从标准 Transformer 的 16.52 提升至 20.05。与使用相同语料、持续预训练相同步数的 Transformer 相比,8B LastKV 将 17 项选定基准的平均分从 46.21 提升至 48.62,其中 HumanEval 从 36.46 提升至 50.30。论文还评测了状态追踪、新视角合成和 teacher forcing 视频生成。训练开销取决于分块大小。