MMICL:通过多模态上下文学习增强视觉语言模型
ICLR 2024 (海报) · PDF · arXiv · 代码 · 海报
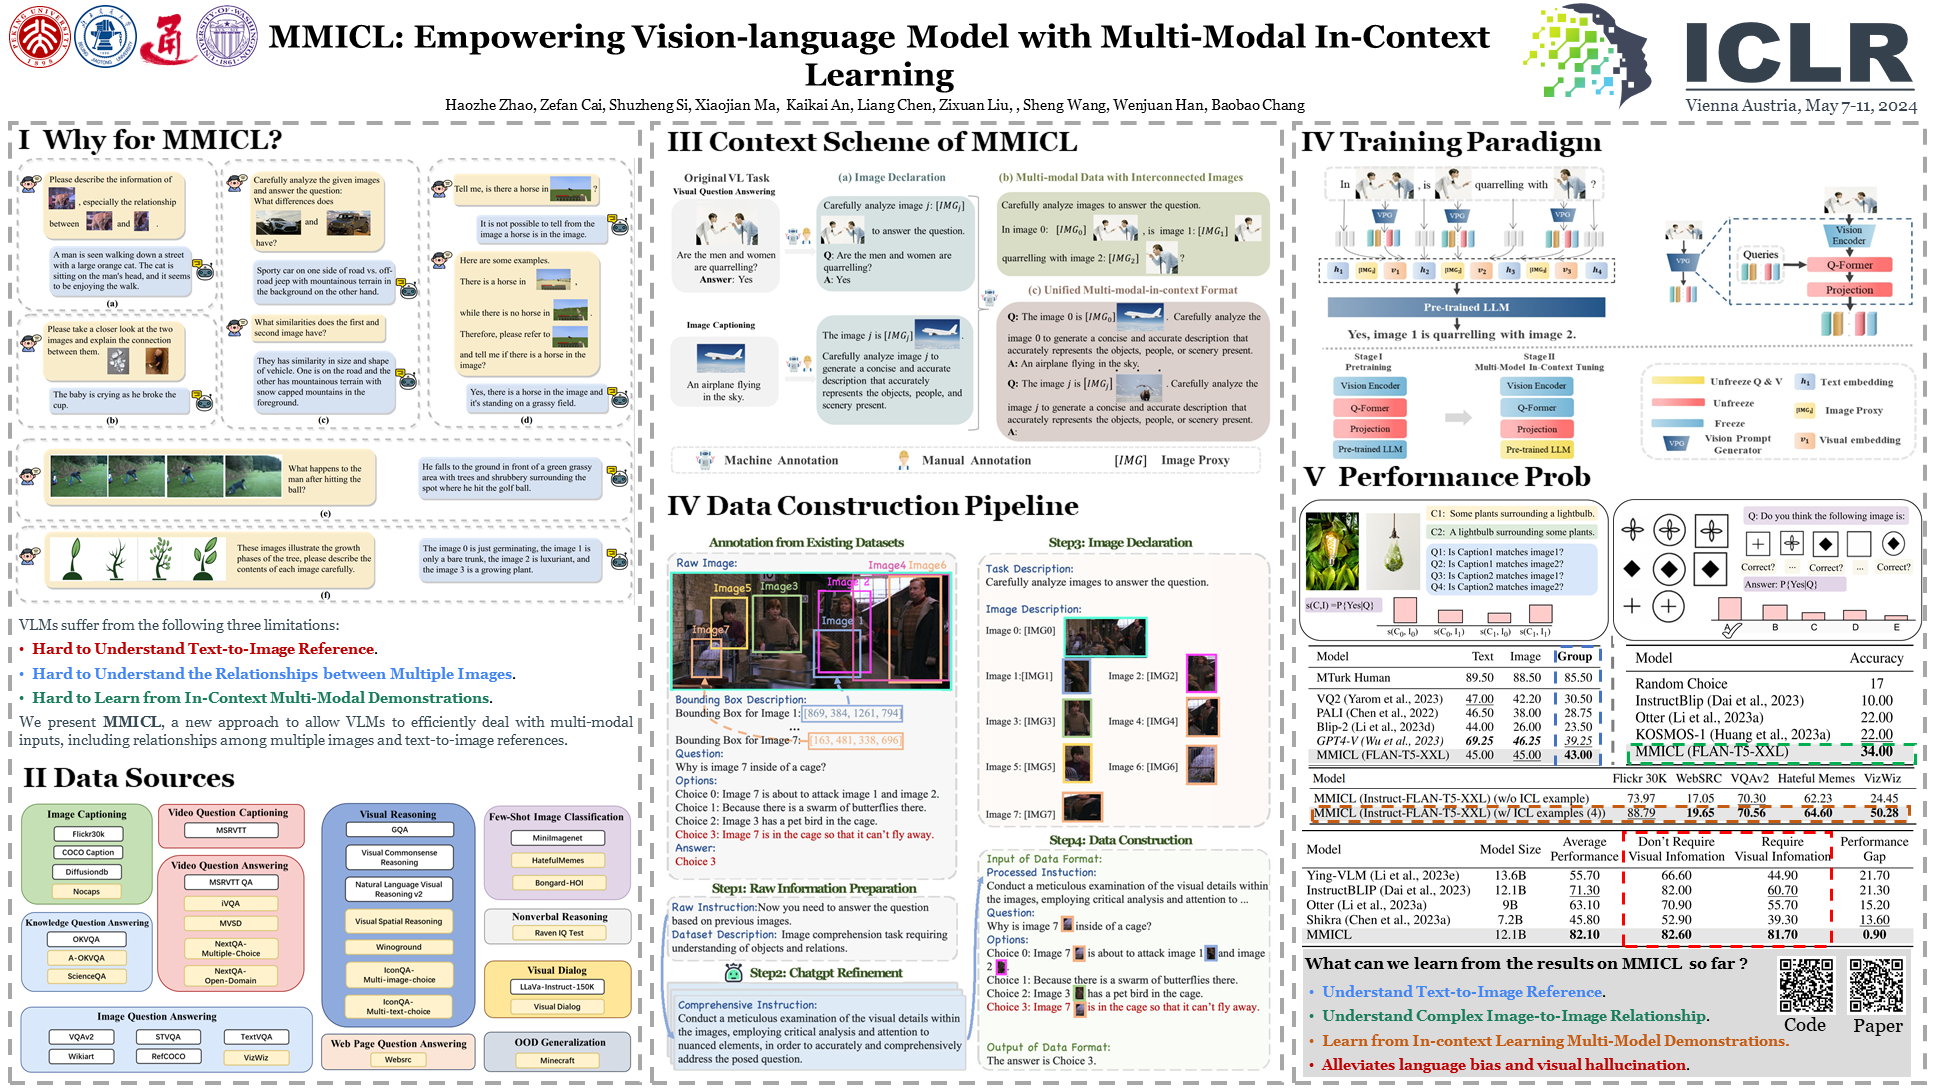
让视觉语言模型从包含多张图像的示例中学习。 MMICL 面向图文交错的提示:文字可能指向某张特定图像,答案也可能依赖多张图像之间的关系。
其上下文格式通过图像声明与图像代理词元,保持文字指代与视觉表示之间的对应。MIC 数据集包含相互关联的图像任务和多模态上下文示例。图文预训练之后,上下文微调更新投影层与语言模型的 query、value 参数,并保持视觉编码器固定。
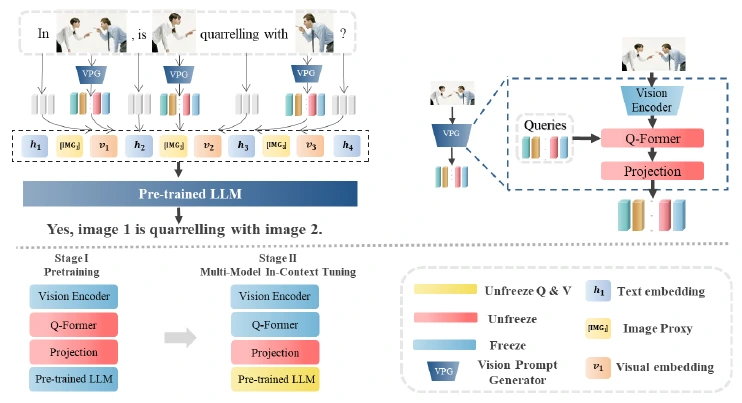
论文构建了 580 万 MIC 样本,报告的微调实验约使用其中 10%。MME、MMBench 等视觉语言任务用于分析多图像理解、上下文学习和语言偏差;性能提升对应论文评测的 BLIP-2/InstructBLIP 配置及当时的对照方法。
资源
数据集: MIC full · MIC sampled
海报