
Multi-Head Attention Residuals(多头注意力残差)
2026 年预印本 · 共同一作 · PDF · 项目主页 · 代码 · MHAR 8B 权重 · 对照模型 8B 权重
让不同特征子空间读取不同的层。 注意力残差让每个子层学习如何混合之前的层输出,但单个路由分布要求所有特征通道以相同比例读取相同的层。Multi-Head Attention Residuals(MHAR)将路由查询拆成多个头,使各特征子空间独立选择深度历史中的信息。只有一个头时,方法退化为普通注意力残差;拆分已有查询本身不增加参数。
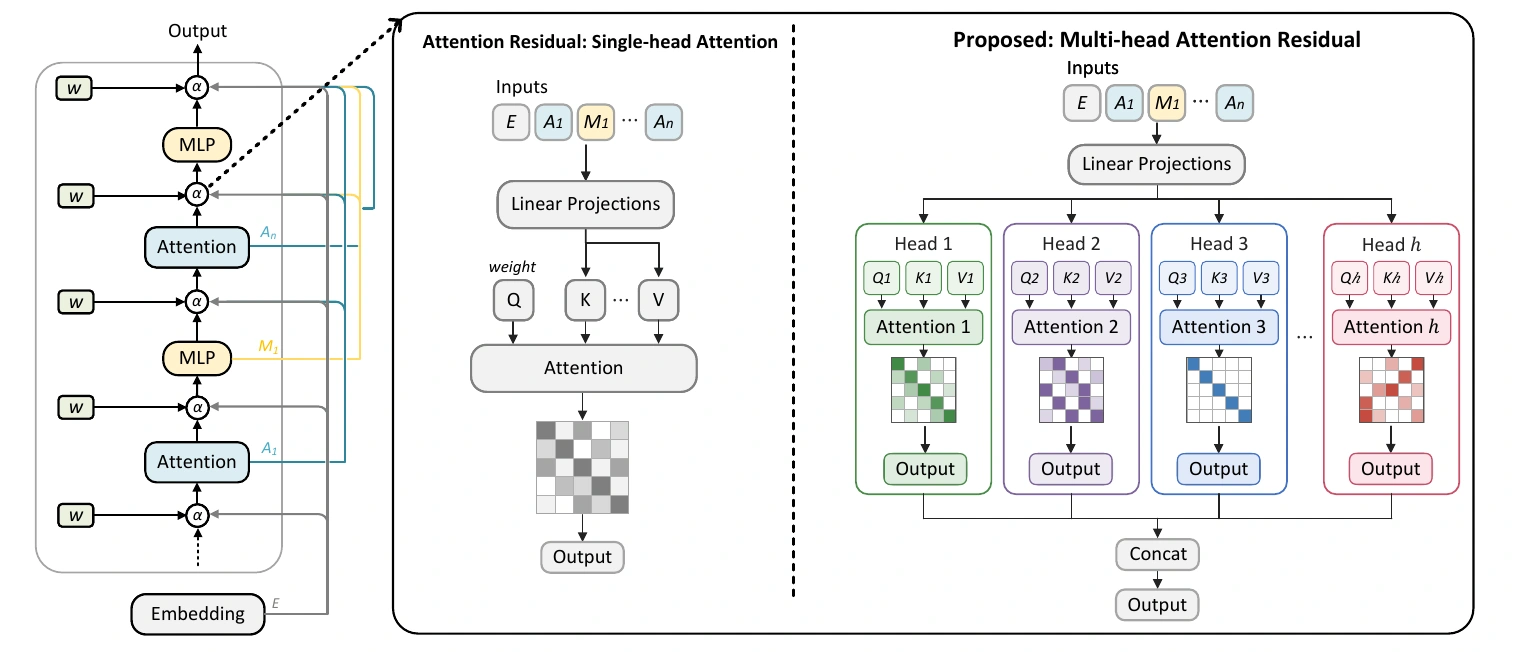
在基于经过质量筛选的 Nemotron 语料、训练步数一致的实验中,相对标准 Transformer,100M、350M 和 1B 模型的验证损失分别降低 0.061、0.149 和 0.140。测试设置下,四个或八个头表现最好。8B 模型通过增量残差形式转换,初始关闭路由门控以保留预训练模型的计算,再在继续训练中学习路由。相对学习率计划、数据顺序和 token 预算一致的对照,GSM8K 提高 3.2 个百分点,GPQA 提高 3.1 个百分点。
读取深度历史仍有计算成本。融合 Triton 核函数使论文中 100M–1B 设置的端到端训练吞吐量达到标准 Transformer 的 0.55–0.88 倍,峰值内存接近基线。与普通 Transformer 的实验保持训练步数一致,论文将直接比较相同运行时间下的表现留作后续工作。