
PyramidKV:基于金字塔式信息汇聚的动态 KV 缓存压缩
COLM 2025 · Spotlight · PDF · 项目主页 · 代码
把缓存留给信息仍然分散的层。 PyramidKV 观察到,注意力模式随深度变化:底层广泛读取上下文,高层则集中到少数关键 token。方法在保持总预算不变的前提下,为底层分配更多 KV 缓存,为高层分配更少缓存;每个头再根据最近指令窗口的注意力,选择要保留的 token。整个过程无需训练模型。
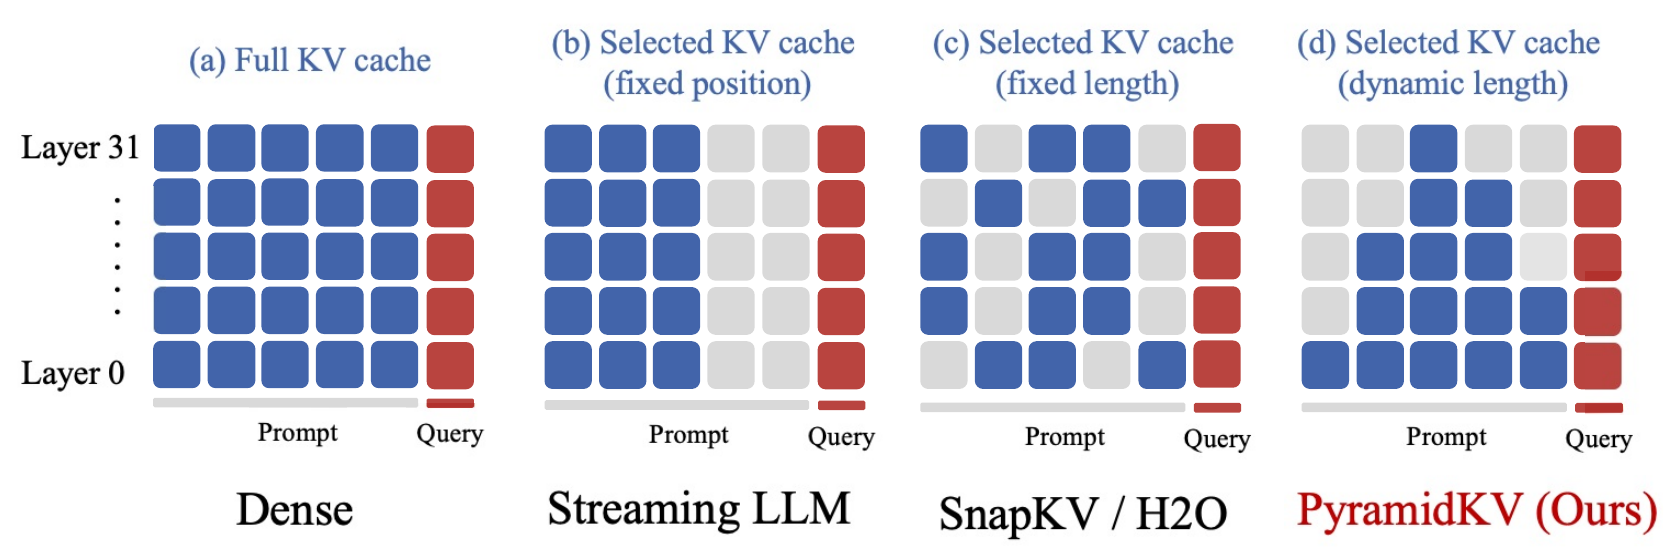
论文在 Llama-3-8B/70B-Instruct 和 Mistral-7B-Instruct 上评测了 LongBench 的 17 个数据集及大海捞针检索。在 2,048-token 缓存预算下,Llama-3-8B-Instruct 的 LongBench 平均分为 41.49,完整缓存为 41.46。将预算压缩到 64 token 时,TREC 准确率为 58.00,SnapKV 为 38.50。这些结果表明,跨层分配缓存能在压缩时保留质量,并在紧预算下带来收益;实际保留的性能取决于模型、任务与缓存大小。