Universal Test-Time Training(通用测试时训练)
COLM 2026 ER Workshop (Spotlight) · PDF · 项目主页 · 代码
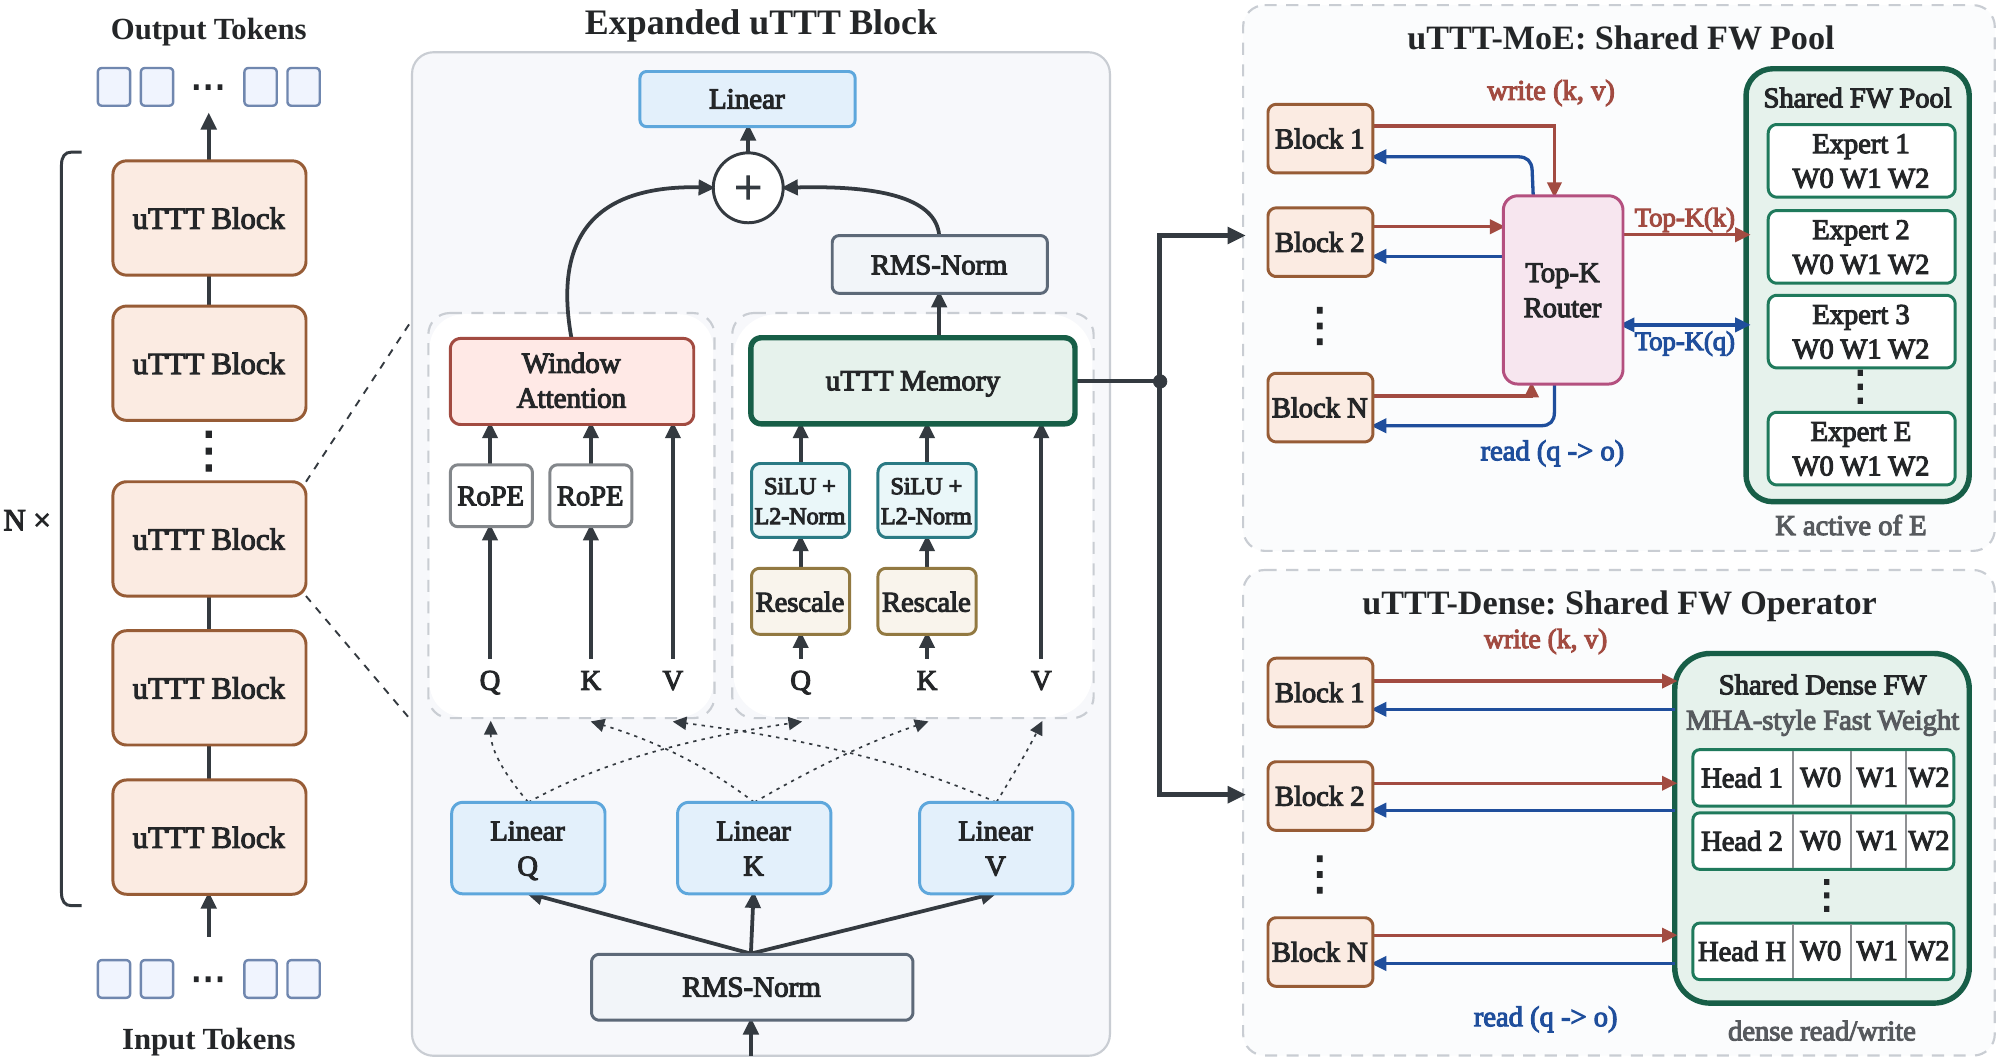
让不同深度的层共享同一份记忆。 大多数测试时训练模型为每层设置独立的快权重,作为随阅读过程更新的紧凑记忆。uTTT 保留各层独立的骨干参数,让所有层都能使用这份记忆。深层写入的信息,可以被后续分块的浅层读取。
论文提出两种实现:uTTT-MoE 将读写路由到共享专家池,uTTT-Dense 使用共享稠密算子。所有层读取分块开始时的状态,在分块边界合并写入,保留分块内部的并行处理。
在总快权重状态与激活计算量匹配时,uTTT-MoE 相比逐层私有的 TTT-MoE,将 RULER 平均检索分数从 124M 的 12.82 提升至 15.46、760M 的 25.73 提升至 27.85;实测配置中的训练速度最高达到 1.39 倍。在物体级新视角合成的第 23 个视角,路由共享带来 0.92 dB 的 PSNR 提升;稠密共享在每层计算量匹配、快权重状态降至八分之一时,提升 0.76 dB。语言检索的平均表现仍低于完整注意力,相对私有记忆的收益也随上下文长度变化。