
HeadInfer:通过按注意力头卸载实现内存高效的大语言模型推理
ICML 2025 长上下文基础模型研讨会(Workshop on Long-Context Foundation Models) · PDF · 代码
按注意力头搬运缓存。 HeadInfer 将完整 KV 历史保存在 CPU 内存中,每次把一个注意力头或一组头调入 GPU 计算。分块预填充限制激活内存,自适应分组减少较短上下文的传输次数,异步预取让缓存搬运与计算重叠。密集注意力版本保留完整注意力计算,不丢弃 token,也不量化缓存。
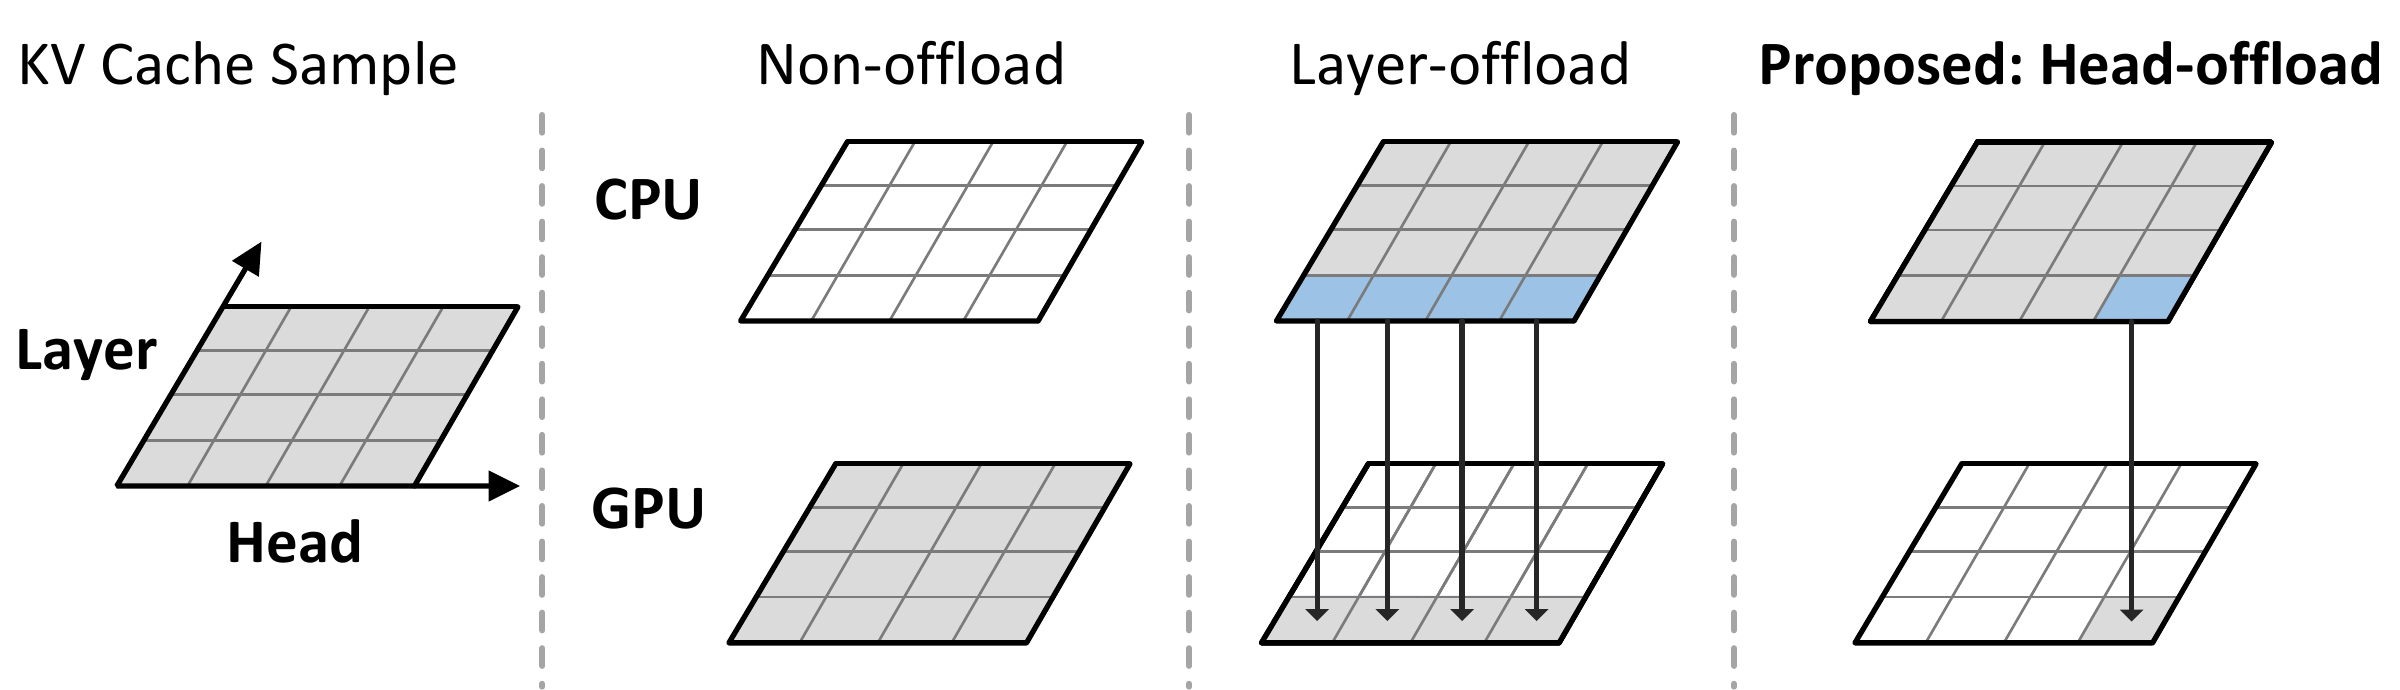
对一百万 token 的 Llama-3-8B,论文报告 GPU 上 1 GB KV 缓存、17 GB 总显存;常规 BF16 推理的估计占用分别为 128 GB 和 207 GB。在配有 1 TB 主机内存、其中 512 GB 分配给 KV 缓存的服务器上,单张 24 GB RTX 4090 可运行 4,096K 上下文。LongBench v2 和 SCBench 检验了避免截断带来的收益。代价是解码延迟:20K 上下文时为 6 token/s,常规推理为 33;一百万 token 时为 0.15 token/s。