
MENTOR:具有均衡多模态控制能力的高效自回归图像生成
Findings of ACL 2026 · PDF · 项目主页 · 代码
既保留参考图像的主体,也遵循文字要求的变化。 MENTOR 将视觉与文字输入映射到共享表示,再通过自回归解码器生成图像词元,目标是在有限训练资源下实现可控生成。
训练分为两个阶段:多模态对齐阶段结合图像重建、目标分割和文生图任务,学习像素细节与语义对应;多模态指令微调阶段再加入互补任务,让模型同时利用视觉细节并遵循指令。
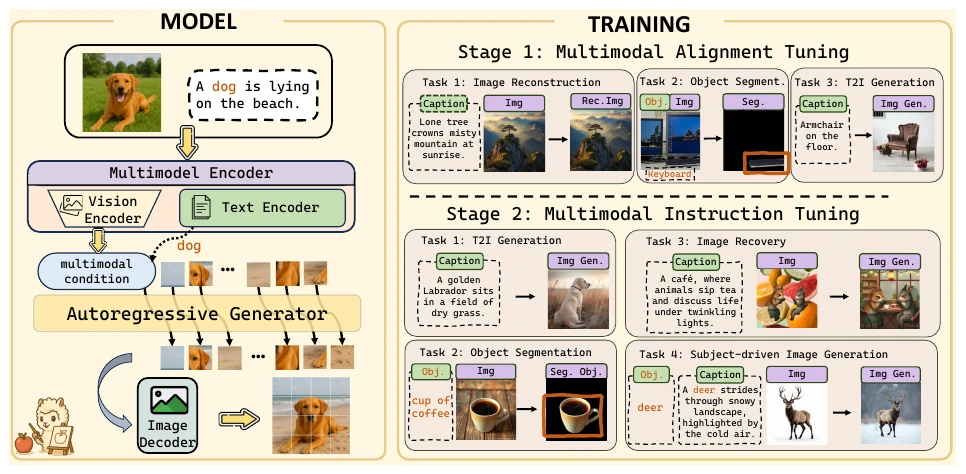
论文报告的 2.31B 参数模型使用 300 万训练样本,在无需测试时微调的方法对比中,DreamBench++ 的主体保留度与提示遵循度乘积为 0.47。实验还分析图像重建、分割和多图像条件生成;结果体现了该评测任务与模型设置下两种输入模态之间的平衡。
资源
模型检查点: Checkpoints