
ML-Bench:评估大语言模型与智能体在代码仓库级机器学习任务中的表现
ICLR DL4C 研讨会 2025 · ICLR Agentic AI for Science 研讨会 2025 (口头报告) · PDF · 研讨会 PDF · 项目主页 · 代码 · Data
评估智能体能否真正运行一个机器学习代码仓库。 ML-Bench 包含来自 18 个 GitHub 仓库的 9,641 个标注样例。每项任务要求模型把用户需求转化为可执行的 Python 或 Bash 代码,通过理解仓库实现和文档选择正确的文件、函数与参数。
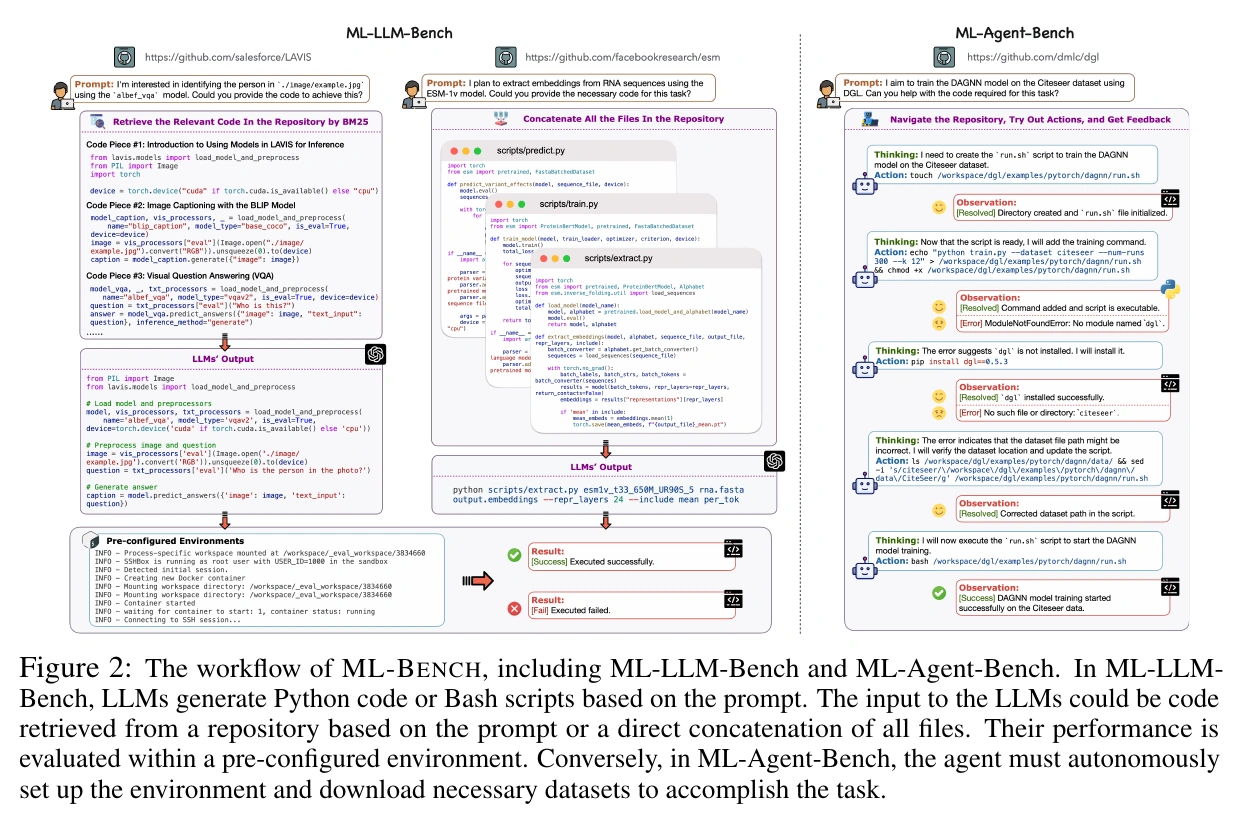
基准区分两种工作流程:ML-LLM-Bench 在预先配置好的环境中评估生成的脚本;ML-Agent-Bench 则要求智能体在 Linux 沙箱中自主配置环境、安装依赖、准备数据并执行任务。仓库理解与执行反馈由此成为评估的一部分。
最新 arXiv 版本报告的实验中,GPT-4o 在 ML-LLM-Bench 的 Oracle 设置下取得超过 50% 的 Pass@5;OpenDevin 搭配 GPT-4o 在 ML-Agent-Bench 上报告 76.47% 的成功率。两项结果使用不同设置和指标。错误分析显示,参数错误、引用不存在的文件,以及 Bash 脚本生成仍是可靠使用仓库的障碍。