MMGR:多模态生成式推理基准与评估
EMNLP 2026 (主会,海报) · MSLD 2026 (海报) · PDF · 项目主页 · 代码 · 数据 · 海报
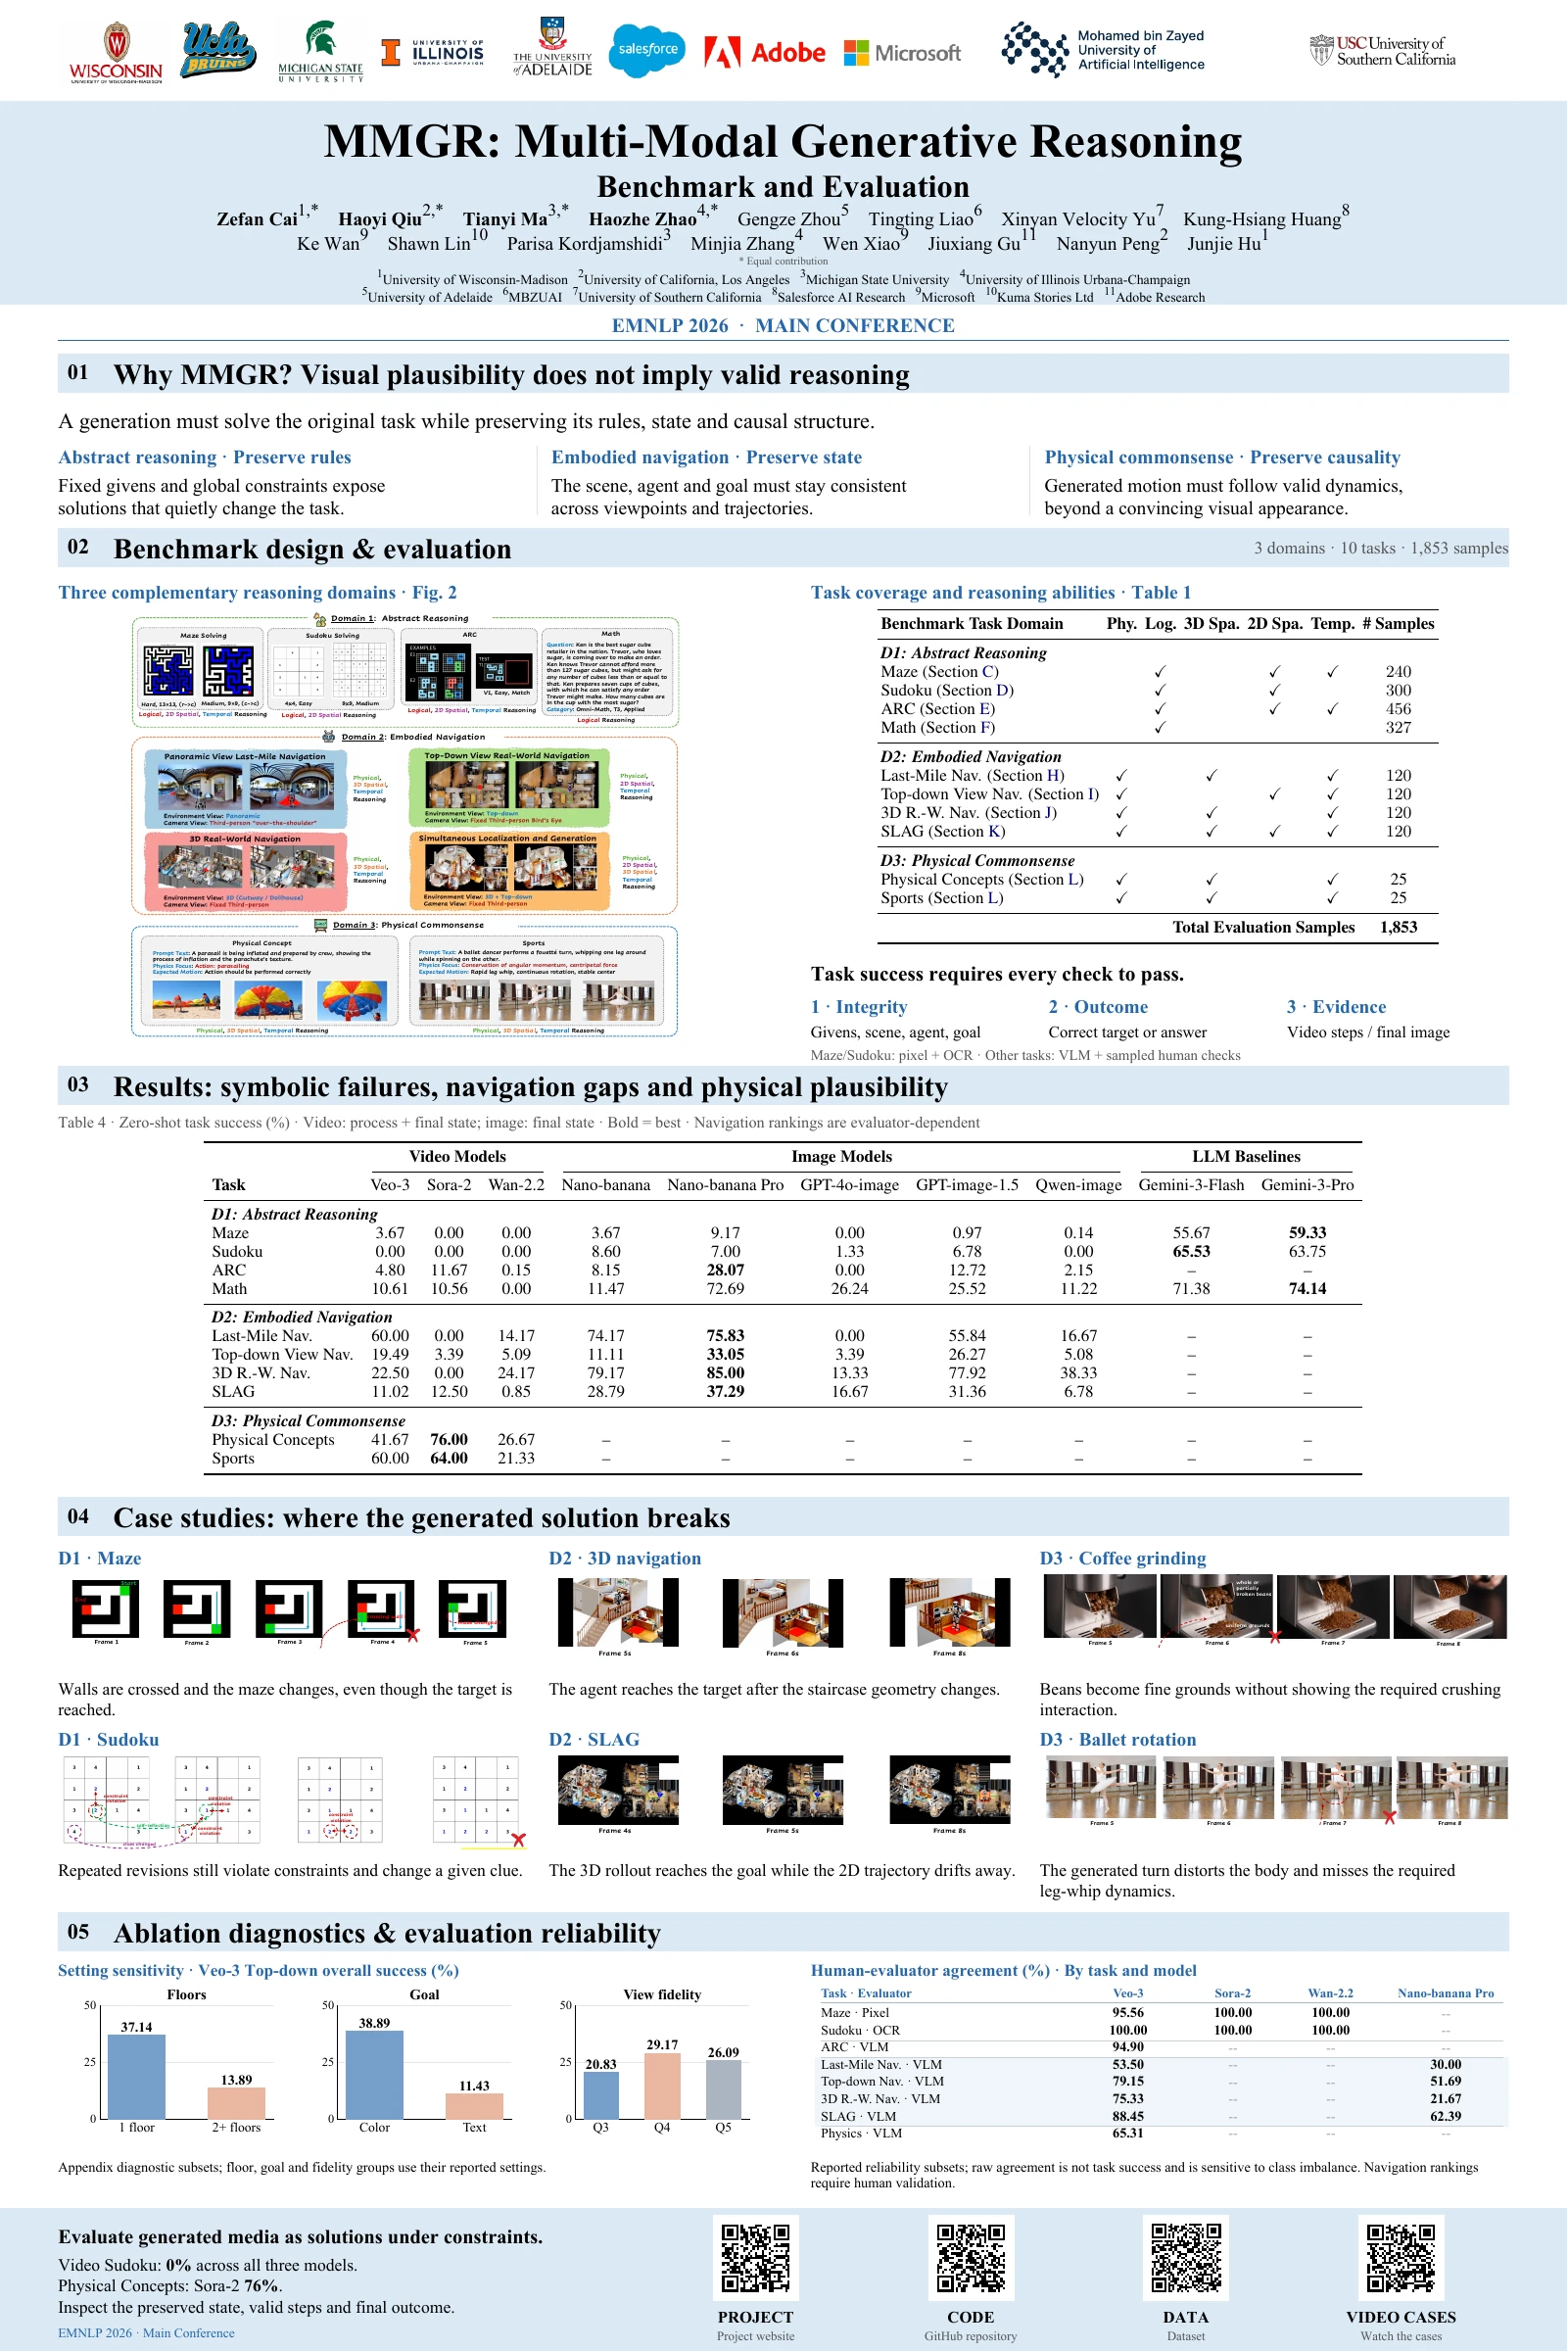
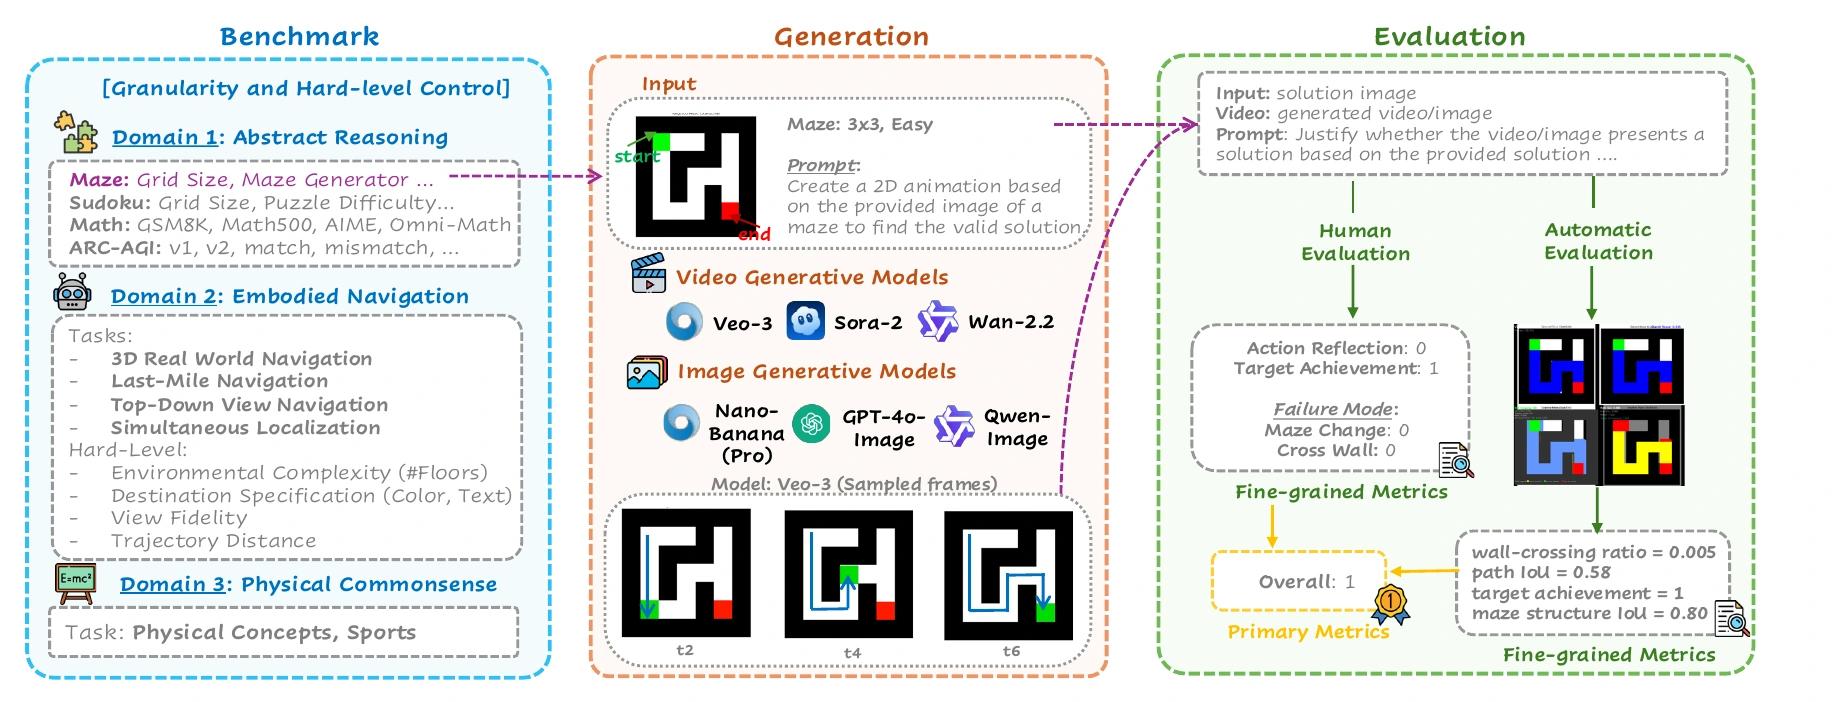
把生成的图像与视频作为推理问题的解来评估。 MMGR 包含 10 项任务、1,853 个实例,涵盖抽象推理、具身导航和物理常识。生成结果在视觉上可信,也需要保持任务规则、状态与因果关系。
迷宫和数独分别使用基于像素的路径重建,以及 OCR 与约束检查;其他任务使用针对任务设计的 VLM 评分规则,论文同时报告与人工评估的一致性。对于视频,逐帧推理评估还检查中间状态是否构成通往最终结果的有效步骤。
在论文报告的零样本实验中,Veo-3、Sora-2 和 Wan-2.2 的数独得分均为 0%,揭示了视觉表现与推理正确性之间的差距。不同任务评测的模型范围有所区别,导航和物理常识的得分需要结合论文报告的评估器可靠性解读。
海报