
R-KV:感知冗余的推理模型 KV 缓存压缩
NeurIPS 2025 · PDF · 项目主页 · 代码 · 视频
保留有用的推理,减少重复内容的缓存。 长思维链常反复讨论相同内容,只看注意力的重要性评分容易保留大量相似 token。R-KV 将注意力重要性与基于 key 向量余弦相似度的冗余惩罚结合,在新 token 缓冲区填满时于解码过程中压缩缓存,无需重新训练。
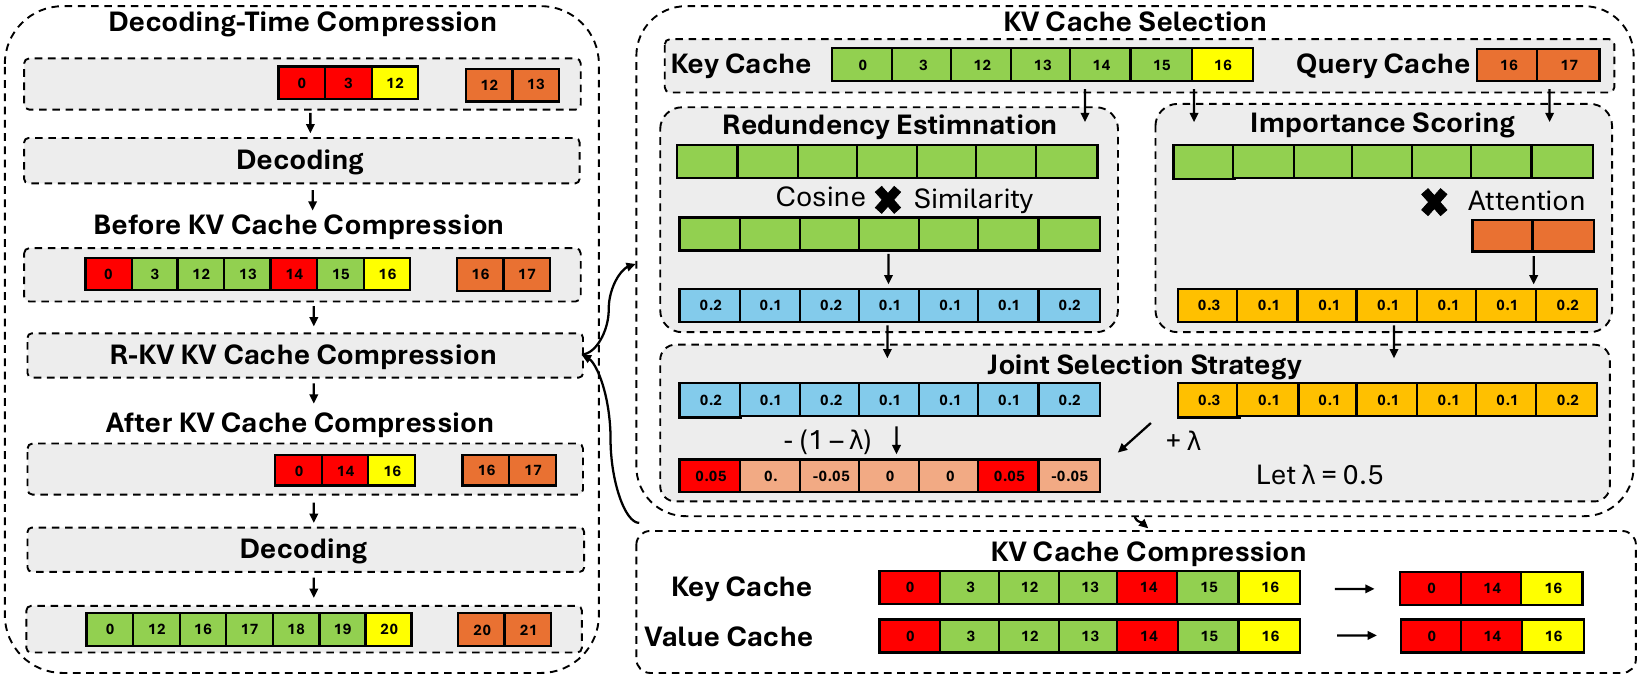
NeurIPS 版本在 MATH-500 和 AIME 2024 上,使用 DeepSeek-R1-Distill-Llama-8B 与 Qwen-14B,对比了解码适配的 SnapKV 和完整缓存。Llama-8B 在 AIME 2024 上使用相当于平均输出长度 10% 的缓存预算即可保留完整缓存的准确率;16% 预算达到其 105%。达到完整缓存表现所需的预算随设置变化:Llama-8B 在 MATH-500 上需要 34%,Qwen-14B 在 AIME/MATH 上分别需要 25%/54%。另一组 Llama3-8B 的 16K-token 系统实验中,10% 缓存预算带来 6.6 倍吞吐量,主要来自可容纳更大的 batch;该测量报告的是批量服务吞吐量。