
Test-Time Training with Next-Token Prediction(利用下一词元预测进行测试时训练)
Findings of EMNLP 2026 · 共同第一作者 · PDF · 代码
用输入中已有的下一词信号写入记忆。 TTT-NTP 将选定 MLP 的下投影矩阵直接作为快权重,把当前位置的 MLP 激活与同一层观察下一个 token 后的上下文状态配对,再通过轻量投影写入。记忆的目标因此来自模型自身的预测计算。训练采用分块并行更新,后续块读取此前的写入,同时保持因果性。
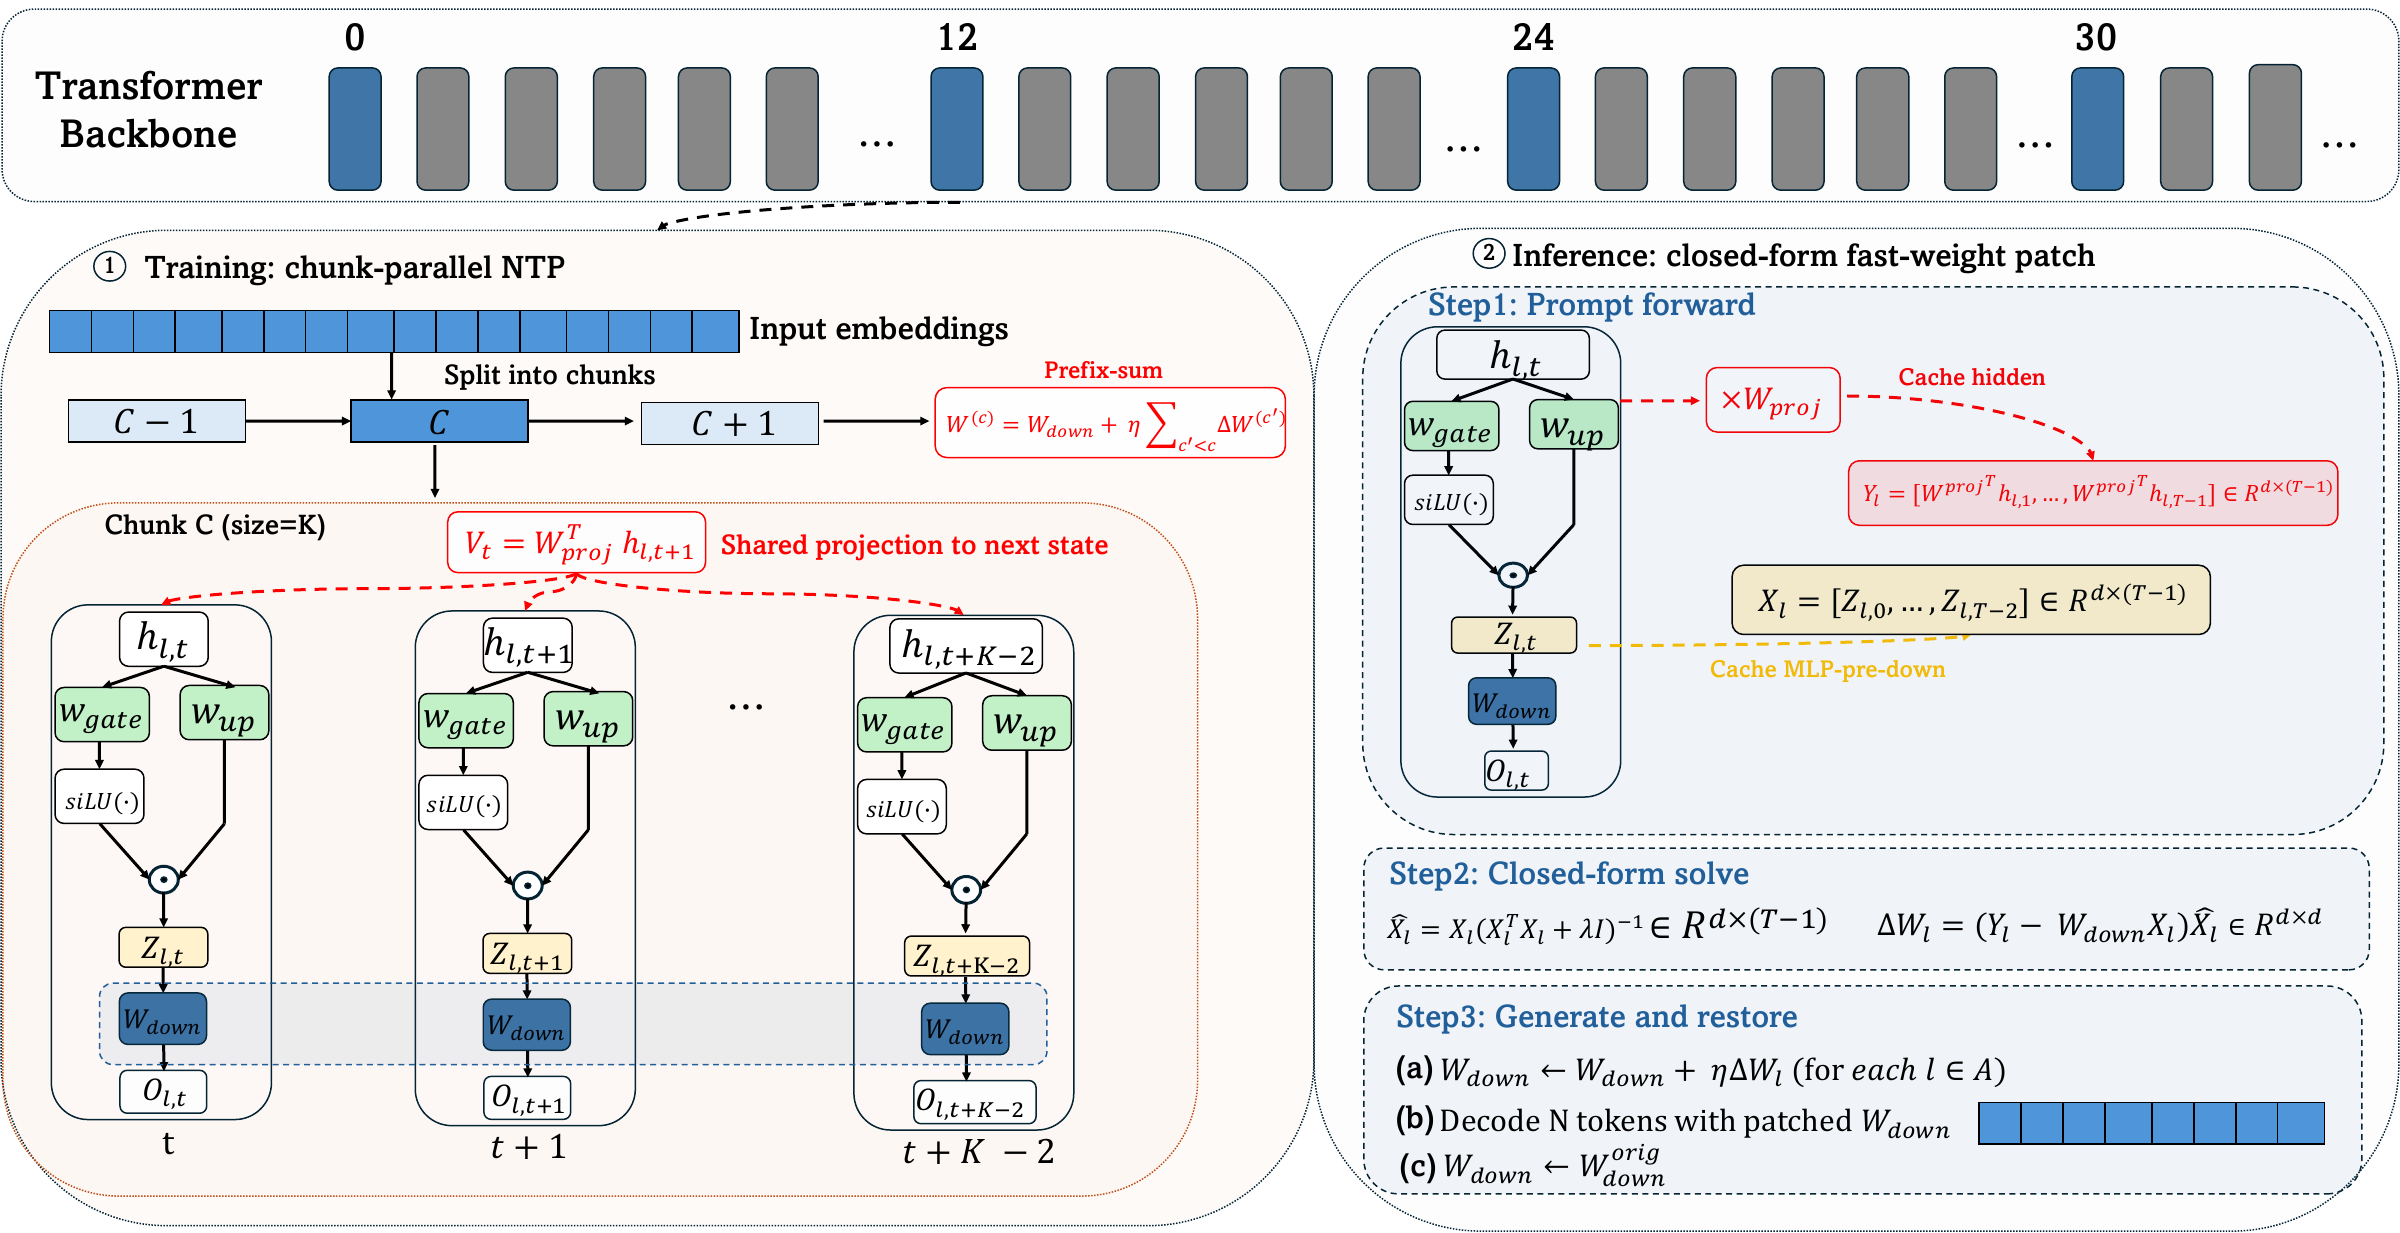
该方法需要先进行持续预训练。推理时,先用一次 prompt 前向收集激活,再通过岭回归求解更新下投影矩阵,随后生成回答。原有 prompt KV 缓存继续使用,每个样本完成后恢复权重。
在 Llama-3.1-8B、Mistral-7B-v0.3、Qwen3-4B 和 Qwen3-0.6B 上,4K–32K 上下文的 RULER Full-13 平均准确率分别比发布的骨干模型提高 3.90、3.03、4.06 和 2.88 个百分点。在 LongBench-v2 的 215 道中等长度问题上,所有方法使用统一的 32K token 预算及首尾截断;Llama 的准确率从 25.6 提升到 31.2,Mistral 从 26.5 提升到 30.2。常识与知识测试的综合表现保持相近。