
VeCAF:感知训练目标的视觉语言协同主动微调
ACM Multimedia 2024 · PDF · 代码
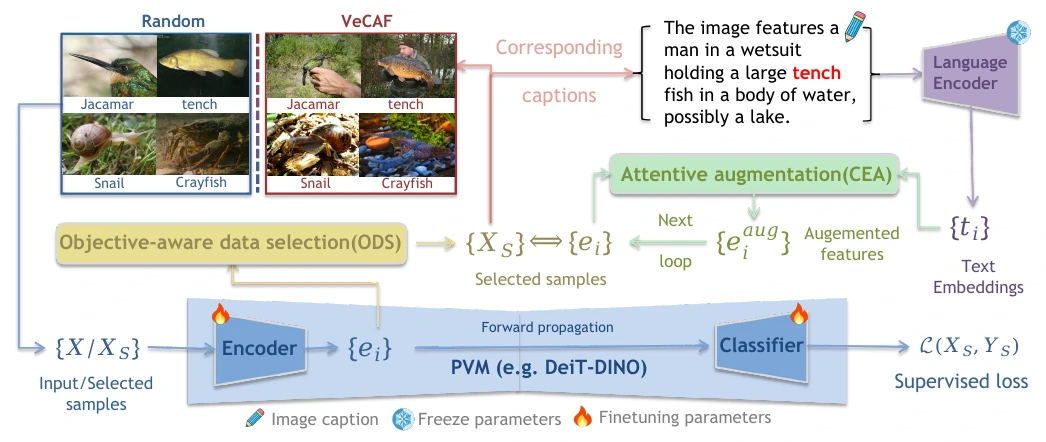
围绕模型需要达到的目标选择训练样本。 VeCAF 研究图像已有标签与描述时的主动微调:从较大的已标注数据集中反复选择小规模子集,高效适配预训练视觉模型。
目标感知数据选择结合当前模型与训练目标,找到具有信息量且保持多样性的样本。随后,跨注意力嵌入增强将所选图像的描述表示引入视觉特征。论文的分布外实验还通过编辑文字描述,让样本选择偏向目标域的特征。
在论文报告的 ImageNet-1K 设置中,VeCAF 达到目标准确率需要 3,075 个训练批次,全量数据微调需要 10,250 个,批次数约减少到 1/3.3。实验还涵盖 CIFAR-10、Caltech101 和 ImageNet-C。该结果衡量论文选择循环与预训练模型设置下的训练批次效率,数据选择本身也有计算成本。